Une tâche de quelques secondes échoue rarement de façon intéressante. Une tâche qui dure vingt minutes sera, tôt ou tard, interrompue par un déploiement, un délai dépassé ou l’API d’un partenaire qui a une mauvaise journée. Le but n’est pas d’empêcher la panne, mais de la rendre peu coûteuse.
La placer dans une file d’attente
Un long traitement ne doit jamais tourner dans une requête web. Placez-le dans une file d’attente, traitez-le dans un worker et laissez l’utilisateur consulter l’état d’avancement. Cela supprime déjà les délais dépassés et permet de dimensionner les workers séparément de l’application web.
Réessayer, mais avec une stratégie
Certaines pannes sont temporaires : une micro-coupure réseau, une limite de débit, une ligne verrouillée. Pour celles-là, on réessaie. Deux règles évitent que les reprises n’aggravent la situation :
- Espacer les tentatives. Attendre de plus en plus longtemps entre chaque essai, au lieu de marteler un service en difficulté.
- Limiter les tentatives. Après quelques essais, s’arrêter et remonter l’échec pour que quelqu’un le regarde.
Ne réessayez pas les erreurs qui ne réussiront jamais, comme une donnée invalide. Faites-les échouer tout de suite, avec un message clair.
Rendre les tâches sûres à exécuter deux fois
Avec les reprises et les redémarrages, une tâche peut s’exécuter plus d’une fois. Concevez chaque étape pour qu’elle soit idempotente : la relancer donne le même résultat, pas une facture en double ni un second e-mail. Une clé unique par opération suffit souvent.
Contrôler la concurrence
Deux workers sur le même enregistrement, ou cinquante tâches qui sollicitent en même temps la même API tierce, créent leurs propres pannes. Utilisez des verrous ou des limites par ressource pour que le nombre de tâches simultanées reste celui que le système supporte.
Les rendre redémarrables
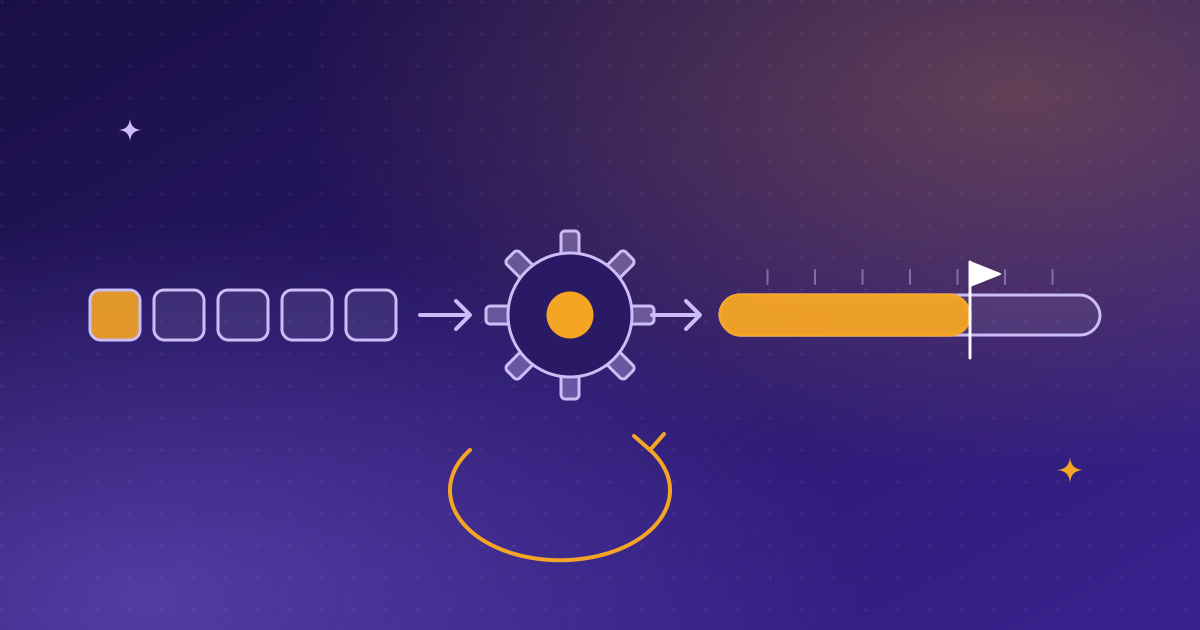
Pour les longues tâches, travaillez par petits lots et enregistrez la progression au fur et à mesure. Si la tâche s’arrête à l’élément 4 000 sur 10 000, un redémarrage doit reprendre à cet endroit, pas recommencer. Une panne devient alors un court retard plutôt qu’un après-midi perdu.
La surveiller
Journalisez ce que fait chaque tâche, suivez les échecs et les durées, et alertez sur les files bloquées. Un système fiable est un système où vous entendez parler des problèmes avant vos utilisateurs.
Si votre produit a des traitements longs qui doivent être fiables, c’est un travail que j’aime, et je serai ravie de vous aider.
Écrit par Michele
Développeuse d'applications sur mesure et IA · Lausanne, Suisse